Qué es Jev: el modelo de TypeSafe AI que decide en vez de escribir
Qué es Jev, el modelo System One de TypeSafe AI: devuelve decisiones tipadas con probabilidades en lugar de texto. Cómo se llama su API, cuánto cuesta y cuándo usarlo.
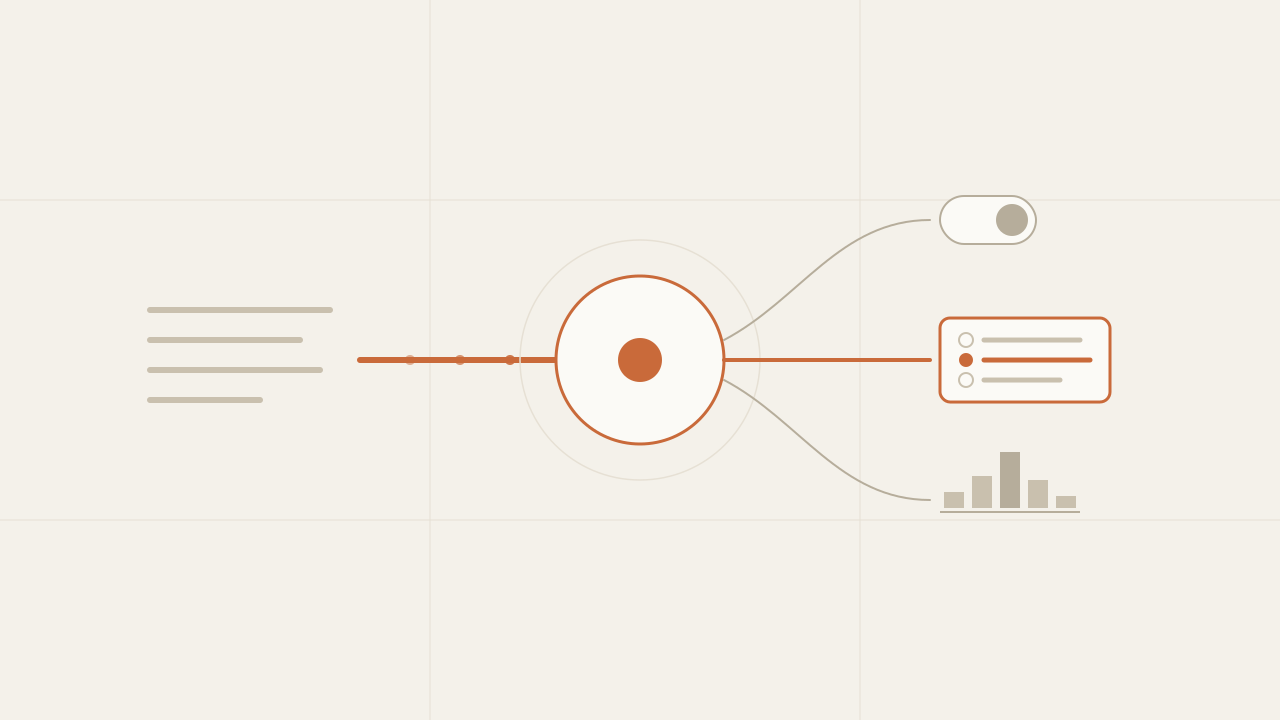
Jev es el primer “modelo System One” de TypeSafe AI: un modelo que no genera texto, sino que recibe un estado y una lista de preguntas tipadas y devuelve valores tipados —un sí o no, una opción de una lista, una puntuación— con probabilidades calibradas. Salió en early access el 15 de septiembre de 2026 y en una semana se volvió el tema de conversación entre quienes construimos sistemas con LLMs. Revisé la documentación y los primeros análisis independientes para responder lo que importa en la práctica: qué es, cómo se llama, cuánto cuesta y en qué parte de un sistema real tiene sentido meterlo.
Resumen para perezosos
- Jev no escribe: responde preguntas de tipo
choice,scoreonoul(sí/no) con un valor, sus probabilidades y un nivel de confianza que tu código puede usar directamente. - Cuesta 0.042 USD por millón de tokens de entrada, la salida es gratis y la latencia publicada va de 70 a 500 ms. Sirve para clasificar, enrutar, priorizar y evaluar, no para redactar ni razonar.
- Úsalo como capa de decisión rápida delante de un LLM: si la confianza es alta actúas, si es baja escalas al modelo grande. Los benchmarks todavía no los ha reproducido nadie independiente.
En este artículo:
- Fundamentos — Qué es Jev · Los tres tipos de pregunta · Precio y velocidad
- Implementación — Llamar a la API · Usar la confianza
- Operación — Dónde encaja · Limitaciones
Qué es Jev y en qué se diferencia de un LLM
Un LLM genera texto token por token. Cuando lo usas para decidir algo —¿este ticket es urgente?, ¿a qué departamento va?— le pides una respuesta en JSON, la parseas y la validas por si el modelo cambió de formato. Buena parte del código que rodea a un LLM en producción existe solo para convertir prosa en un valor que el programa pueda usar.
Jev elimina ese paso. Le mandas un state (el contexto: un mensaje, un documento, el historial de un agente) y un mapa de preguntas, cada una con un tipo declarado. Lo que vuelve no es texto, sino el valor del tipo que pediste más una distribución de probabilidades. No hay nada que parsear y el modelo no puede inventar una categoría que no existe, porque solo puede elegir entre las que definiste.
TypeSafe AI lo llama “System One” por la distinción entre pensamiento rápido e intuitivo (sistema 1) y lento y deliberado (sistema 2). La idea es que los LLMs actuales cubren el sistema 2 y que una gran parte de las decisiones de un software no necesita deliberación, sino un juicio rápido y medible. La empresa tiene sede en San Francisco, la fundó Diogo Almeida —ex investigador de OpenAI y uno de los coautores de RLHF— y anunció junto al lanzamiento una ronda semilla de 40 millones de USD liderada por DCVC. La demo que más circuló fue Jev jugando Doom: recibe un frame y devuelve el siguiente movimiento, sin comentario de por medio.
Los tres tipos de pregunta: choice, score y noul
Toda la API se reduce a tres primitivas. Cada pregunta que le haces a Jev es de uno de estos tipos:
| Tipo | Qué responde | Qué devuelve | Ejemplo |
|---|---|---|---|
choice | Una opción de una lista cerrada | La opción elegida, su confianza y la probabilidad de cada opción | ¿A qué departamento va este ticket? |
score | Un nivel en una escala ordenada de 2 a 10 niveles | La puntuación, su confianza y la distribución por nivel | ¿Qué tan frustrado está el cliente, de 1 a 5? |
noul | Sí o no | La probabilidad de que la afirmación sea verdadera, entre 0 y 1 | ¿El mensaje pide una devolución? |
La diferencia entre la respuesta y la confianza es lo más útil del diseño. La respuesta dice qué eligió el modelo; la confianza, calculada a partir de la forma de la distribución, dice si conviene actuar. Si la probabilidad se concentra en una opción, la confianza es alta. Si está repartida entre dos o tres, es baja, aunque la opción ganadora sea la misma. Con un LLM esa señal no existe de forma nativa: te devuelve una categoría con la misma seguridad aparente cuando acierta que cuando duda.
Cuánto cuesta Jev y qué tan rápido es
El precio publicado para el early access es de 0.042 USD por millón de tokens de entrada, y los tokens de salida son gratis. Tiene sentido: la salida es un número o una etiqueta, no un párrafo. Para poner la cifra en contexto, en el post sobre routing de modelos usé DeepSeek V4 Flash como modelo barato a 0.09 USD de entrada y 0.18 de salida por millón; Jev cobra menos de la mitad por la entrada y nada por la salida.
La latencia publicada va de 70 a 500 ms de extremo a extremo. TypeSafe afirma que en consultas comparables es entre 40 y 200 veces más rápido y barato que un LLM grande, y la cobertura de prensa ha repetido rangos distintos para la misma afirmación.
TypeSafe reconoce que sus evaluaciones las escribió su propio equipo y que las respuestas de referencia salieron de modelos de OpenAI y Anthropic. Ningún arnés neutral ha reproducido todavía sus benchmarks. Mientras eso no pase, trata las cifras de velocidad y precisión como una hipótesis que hay que medir con tus datos.
El precio es de early access, no una tarifa de disponibilidad general, y el acceso pasa por una lista de espera en la consola de TypeSafe. Antes de diseñar un producto alrededor de ese costo, asume que puede cambiar.
Cómo se llama a la API de Jev
La API tiene un solo endpoint: POST https://api.typesafe.ai/v1/systemone, con la API key como Bearer token. El cuerpo lleva el model (jev-latest durante el early access), el state y un mapa de questions donde cada clave es el nombre con el que vas a leer la respuesta. Los tipos van en minúscula (choice, score, noul); en mayúscula la API responde con un 400.
La petición mínima, con curl:
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Llevo 3 días intentando conectar Stripe y la integración sigue fallando. Estoy perdiendo ventas.",
    "questions": {
      "is_urgent": { "type": "noul", "instructions": "El cliente está perdiendo dinero ahora mismo." },
      "department": {
        "type": "choice",
        "instructions": "Qué equipo debe atender este ticket.",
        "criteria": {
          "billing": "Cobros, facturas y reembolsos",
          "technical": "Errores e integraciones",
          "sales": "Planes y contrataciones"
        }
      }
    }
  }'
La respuesta llega en answers, con una entrada por pregunta: answers.is_urgent.noul es un número entre 0 y 1, y answers.department trae choice, confidence y probabilities. Envuelto en una función que el resto del código pueda llamar:
// lib/jev.ts
const JEV_URL = "https://api.typesafe.ai/v1/systemone";

type TicketDecision = {
  department: string;
  confidence: number;
  isUrgent: number; // probabilidad entre 0 y 1
};

export async function triageTicket(text: string): Promise<TicketDecision> {
  const res = await fetch(JEV_URL, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${process.env.TYPESAFE_API_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: "jev-latest",
      state: text,
      questions: {
        is_urgent: { type: "noul", instructions: "El cliente está perdiendo dinero ahora mismo." },
        department: {
          type: "choice",
          instructions: "Qué equipo debe atender este ticket.",
          criteria: {
            billing: "Cobros, facturas y reembolsos",
            technical: "Errores e integraciones",
            sales: "Planes y contrataciones",
          },
        },
      },
    }),
  });
  if (!res.ok) throw new Error(`Jev respondió ${res.status}`);

  // No hay texto que parsear: cada respuesta ya viene con su tipo.
  const { answers } = await res.json();
  return {
    department: answers.department.choice,
    confidence: answers.department.confidence,
    isUrgent: answers.is_urgent.noul,
  };
}
# lib/jev.py
import os
import requests
JEV_URL = "https://api.typesafe.ai/v1/systemone"
def triage_ticket(text: str) -> dict:
res = requests.post(
JEV_URL,
headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
json={
"model": "jev-latest",
"state": text,
"questions": {
"is_urgent": {"type": "noul", "instructions": "El cliente está perdiendo dinero ahora mismo."},
"department": {
"type": "choice",
"instructions": "Qué equipo debe atender este ticket.",
"criteria": {
"billing": "Cobros, facturas y reembolsos",
"technical": "Errores e integraciones",
"sales": "Planes y contrataciones",
},
},
},
},
timeout=5,
)
res.raise_for_status()
# No hay texto que parsear: cada respuesta ya viene con su tipo.
answers = res.json()["answers"]
return {
"department": answers["department"]["choice"],
"confidence": answers["department"]["confidence"],
"is_urgent": answers["is_urgent"]["noul"], # probabilidad entre 0 y 1
}<?php
// lib/jev.php
const JEV_URL = "https://api.typesafe.ai/v1/systemone";
function triage_ticket(string $text): array {
$payload = [
"model" => "jev-latest",
"state" => $text,
"questions" => [
"is_urgent" => ["type" => "noul", "instructions" => "El cliente está perdiendo dinero ahora mismo."],
"department" => [
"type" => "choice",
"instructions" => "Qué equipo debe atender este ticket.",
"criteria" => [
"billing" => "Cobros, facturas y reembolsos",
"technical" => "Errores e integraciones",
"sales" => "Planes y contrataciones",
],
],
],
];
$ch = curl_init(JEV_URL);
curl_setopt_array($ch, [
CURLOPT_POST => true,
CURLOPT_RETURNTRANSFER => true,
CURLOPT_TIMEOUT => 5,
CURLOPT_HTTPHEADER => [
"Authorization: Bearer " . getenv("TYPESAFE_API_KEY"),
"Content-Type: application/json",
],
CURLOPT_POSTFIELDS => json_encode($payload),
]);
$body = curl_exec($ch);
$status = curl_getinfo($ch, CURLINFO_HTTP_CODE);
curl_close($ch);
if ($status !== 200) {
throw new RuntimeException("Jev respondió $status");
}
// No hay texto que parsear: cada respuesta ya viene con su tipo.
$answers = json_decode($body, true)["answers"];
return [
"department" => $answers["department"]["choice"],
"confidence" => $answers["department"]["confidence"],
"is_urgent" => $answers["is_urgent"]["noul"], // probabilidad entre 0 y 1
];
}Compara esto con el parseJSON tolerante y el validador del post de routing: aquí no hacen falta. La API está en early access y los nombres de campos pueden cambiar, así que toma los definitivos de la documentación oficial antes de llevarlo a producción. TypeSafe también publica SDKs para Python y JavaScript si prefieres no armar la petición a mano.
Cómo usar la confianza para decidir cuándo actuar
La forma correcta de integrar Jev no es reemplazar al LLM, sino ponerlo delante. Jev decide los casos claros en milisegundos y a costo casi nulo; los casos donde duda pasan al modelo grande, que es más lento y caro pero puede razonar. El recorrido de una petición, en orden:
-
Llega el caso — un ticket, un mensaje, un paso de un agente
-
Jev responde — valor + confianza en menos de un segundo
-
Se compara la confianza con tu umbral
El umbral lo defines tú por pregunta, y se ajusta con datos reales, no a priori.
¿La confianza supera el umbral?
- Sí — el código actúa con el valor de Jev: asigna, enruta o descarta.
- No — el caso escala a un LLM o a una persona, y ese resultado se registra para recalibrar el umbral.
Es el mismo patrón de “intentar barato, validar, escalar” del routing de modelos, con una ventaja: la validación ya no es una heurística tuya sobre el JSON, es una señal que el propio modelo entrega. Registra cuántos casos resuelve Jev y cuántos escalan. Si ese porcentaje baja, o cambió el tipo de tráfico o el umbral quedó demasiado estricto.
Dónde encaja Jev en un sistema con LLMs
Jev sirve en cualquier punto donde tu código hace una pregunta cerrada sobre un contexto y necesita la respuesta rápido y muchas veces. Los casos más directos:
- Routing de modelos: decidir si una petición la resuelve el modelo barato o necesita el premium. Hoy esa decisión suele ser una tabla de reglas o una llamada extra a un LLM pequeño; Jev es una tercera opción con probabilidades incluidas.
- Triage y clasificación: tickets de soporte, moderación de contenido, priorización de leads, filtrado de noticias por relevancia.
- Evaluación dentro de un agente: en un agent loop, cada vuelta necesita un juicio —¿la tarea está terminada?, ¿el resultado cumple el criterio?— y ese juicio se repite cientos de veces. Es el mismo problema que describí en quién escribe los tests del agente, pero con un evaluador que devuelve un
noulen lugar de un párrafo. - Decisiones en tiempo real: bots, juegos, cualquier sistema donde la latencia de un LLM no es aceptable.
Donde no encaja: redactar, resumir, extraer campos de texto libre o cualquier tarea cuya salida sea contenido y no una decisión. Para eso sigue haciendo falta un LLM.
Limitaciones de Jev que conviene conocer
TypeSafe publica una lista de debilidades conocidas en sus notas de la versión 1.13 de Jev, y es más honesta que la mayoría de los lanzamientos. Antes de adoptarlo:
- Contexto de 32k tokens. Suficiente para un ticket o un paso de agente, corto para un documento largo.
- Máximo 255 opciones por
choice. Por encima de eso cambia a un método en dos etapas, más lento. - No cuenta de forma fiable y tiene problemas con matemáticas y comparación de fechas. Si la decisión depende de “más de 3 incidentes” o “antes del día 15”, calcula eso en código y pásale el resultado.
- Interpreta las instrucciones de forma demasiado literal y pierde precisión en razonamiento indirecto de varios pasos.
- Se degrada con contexto irrelevante. Mándale solo lo necesario para la pregunta, no el historial completo por comodidad.
- No explica por qué. Devuelve un número sin justificación, lo que complica depurar errores y auditar decisiones en dominios regulados.
La última es la que más pesa en producción. Cuando un LLM clasifica mal, puedes leer su razonamiento; cuando Jev clasifica mal, solo tienes la distribución de probabilidades. Por eso conviene guardar el state, la pregunta y la respuesta completa de cada llamada: es la única forma de reconstruir un error después.
Preguntas frecuentes
¿Qué es Jev de TypeSafe AI?
Jev es un modelo de inteligencia artificial de TypeSafe AI lanzado en early access el 15 de septiembre de 2026. A diferencia de un LLM, no genera texto: recibe un contexto y preguntas tipadas, y devuelve valores tipados (sí o no, una opción de una lista o una puntuación) junto con probabilidades calibradas y un nivel de confianza. Está pensado para que lo consuma otro programa, no una persona.
¿Jev reemplaza a ChatGPT o Claude?
No. Jev no puede redactar, resumir ni razonar en varios pasos, y no devuelve explicaciones. Reemplaza solo la parte de un sistema donde hoy se usa un LLM para tomar una decisión cerrada, como clasificar o enrutar. Lo razonable es usarlo delante del LLM: Jev resuelve los casos claros y el LLM los ambiguos.
¿Cuánto cuesta usar Jev?
El precio publicado durante el early access es de 0.042 USD por millón de tokens de entrada, con los tokens de salida gratis. Es una tarifa de acceso anticipado y TypeSafe no la ha confirmado como precio de disponibilidad general, así que puede cambiar. El acceso se solicita por lista de espera en la consola de TypeSafe.
¿Qué significa que Jev sea un modelo “System One”?
Es una referencia a la distinción entre pensamiento rápido e intuitivo (sistema 1) y lento y deliberado (sistema 2). TypeSafe AI usa el término para una categoría de modelos que toman juicios rápidos y medibles en lugar de generar razonamiento. Jev es el primer modelo de esa categoría.
¿Qué son los tipos choice, score y noul en Jev?
Son las tres primitivas de la API. choice elige una opción de una lista cerrada, score asigna un nivel en una escala ordenada de 2 a 10 niveles, y noul devuelve la probabilidad de que una afirmación sea verdadera. choice y score incluyen además un valor de confianza entre 0 y 1 calculado a partir de la distribución de probabilidades.
Conclusión
Jev no es un LLM más rápido: es otra categoría de modelo, que devuelve decisiones con tipo y probabilidad en lugar de texto. Su valor real está en la parte más repetitiva de un sistema con IA, la de las preguntas cerradas que hoy resolvemos con un LLM, un JSON y un validador. Si quieres probarlo sin arriesgar nada, empieza así: pide acceso, elige una sola decisión que tu sistema ya toma con un LLM (clasificar tickets, enrutar peticiones), corre Jev en paralelo sobre el mismo tráfico sin actuar con su respuesta, compara resultados y confianza durante unos días, y solo entonces define el umbral a partir del cual dejas que decida.
Datos sensibles fuera del prompt: una librería de TypeScript escrita en 39 minutos desde su especificación
sanitype redacta, enmascara o elimina datos sensibles dentro del proceso antes de que un payload salga hacia un LLM, un log o un tercero. Así está implementada en TypeScript.
Leer más
Spec-Driven Development en React Native: un MVP que lista los sismos del mundo, especificado antes de escribir código
Apliqué Spec-Driven Development a un MVP en React Native que lista los sismos del mundo: la especificación decide qué entra en la lista y sus criterios de aceptación se convierten en los tests.
Leer más
Agente de voz que agenda citas: ElevenLabs, Cal.com y un backend que no deja adivinar al modelo
Cómo monté un agente de voz que agenda citas de 30 minutos con ElevenLabs y Cal.com, y por qué el backend en Fastify es lo que evita que el modelo invente horarios.
Leer más